Серии учебных материалов
Используйте единый характер голоса в уроках и пояснениях. Новые фрагменты проще согласовать по подаче, если исходный образец записан спокойно и последовательно.
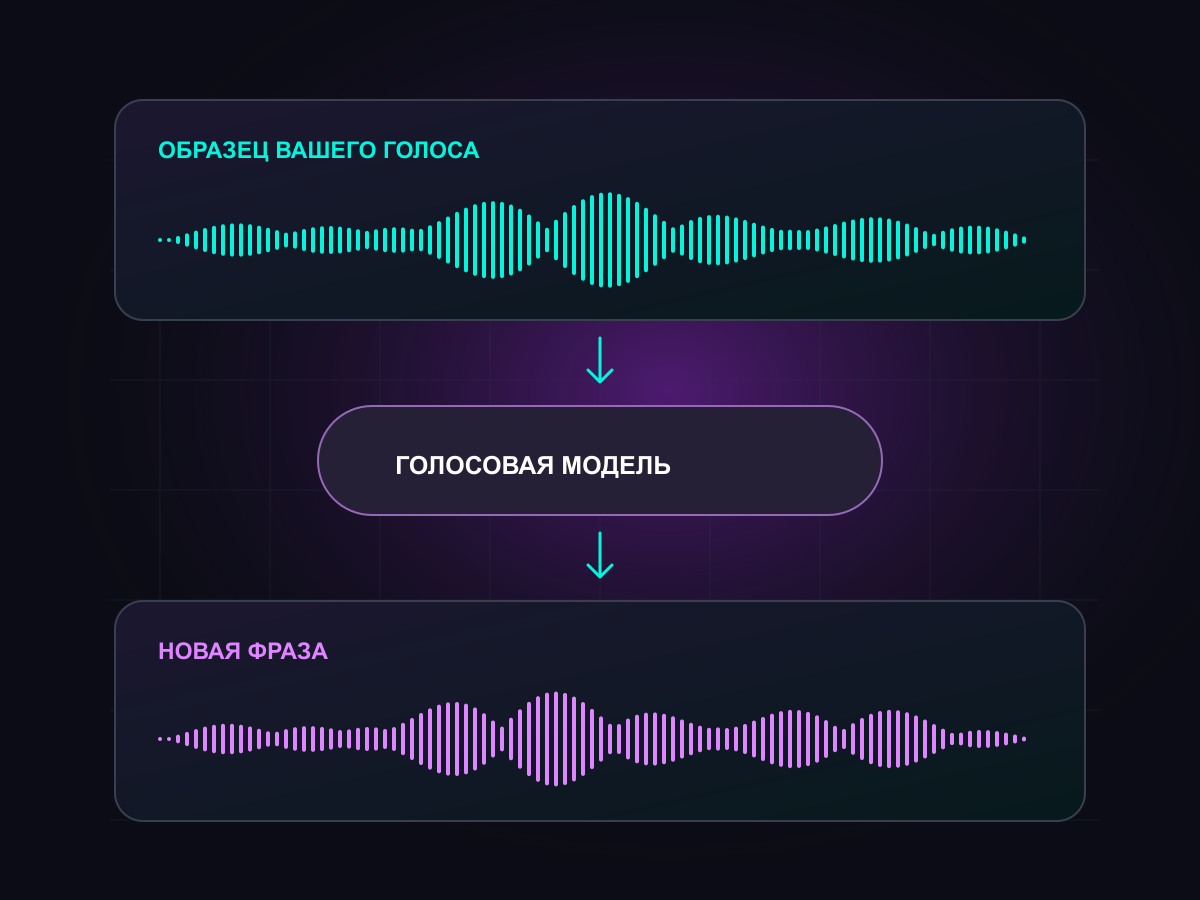
Персональная модель нужна, когда новые тексты должны звучать узнаваемым голосом. В отличие от выбора готового диктора, клонирование опирается на образец речи конкретного человека и качество этой записи.
Используйте единый характер голоса в уроках и пояснениях. Новые фрагменты проще согласовать по подаче, если исходный образец записан спокойно и последовательно.
Подготовьте голос для авторских текстов, заметок и творческих проектов. Проверяйте, соответствует ли интонация смыслу, а не только привычному тембру.
Для новой версии сценария можно подготовить отдельные реплики. Прослушайте их рядом с остальной дорожкой: громкость, темп и эмоциональность должны сочетаться.
Говорите в тихой комнате, без музыки и эффектов. Используйте собственный голос или запись человека, который явно разрешил такое использование.
Читайте разные по длине предложения привычным голосом. Не шепчите и не изображайте диктора, если хотите сохранить обычную манеру звучания.
Оцените модель на тексте, которого не было в образце. Прослушайте знакомые слова, имена и вопросительные предложения — сходство проявляется не только в тембре.
Запись для голосовой модели должна передавать речь одного человека без музыки и эффектов. Разные по длине фразы и звуковому составу слова помогают представить привычную манеру произношения.
Записывайте фрагменты на одном устройстве и с похожей дистанции. Не добавляйте реверберацию, музыку или голосовые фильтры к материалу для образца.
Узнаваемый тембр ещё не гарантирует верную эмоцию. Слушайте, где голос делает акцент, как произносит сложные слова и не превращает вопрос в утверждение.
Отбирая запись для голосовой модели, слушайте каждую фразу от первого вдоха до завершения мысли. Отмечайте оговорки, кашель, постороннюю речь и случайные звуки возле микрофона. Если ошибка попала внутрь предложения, выберите другой цельный дубль или повторите его, вместо того чтобы собирать слова по слогам.
Сохраните принятые и отклонённые записи раздельно, а причину замены укажите в короткой заметке. Это поможет не включить неудачный фрагмент обратно при следующей сборке образца. В итоговой подборке проверяйте также переходы между записями: фразы должны оставаться самостоятельными, без случайно отрезанных начала и конца.
Для озвучки на другом языке сначала уточните, поддерживает ли его выбранный инструмент. Затем составьте небольшой набор из обычной реплики, имени, вопроса и термина из вашего проекта. Например, в казахском тексте полезно отдельно послушать слова со звуками ә, ң и ұ, а затем ту же речь в связной фразе.
Попросите человека, свободно владеющего языком, оценить произношение и естественность. Обсуждайте конкретные места: какой звук изменился, где пауза мешает смыслу, какое имя трудно узнать. Сходство тембра оценивайте отдельно — знакомый голос может всё ещё неверно произносить слова нового сценария.
Для каждого готового фрагмента сохраняйте точный текст и обозначение использованной голосовой модели. Добавьте дату и доступные настройки синтеза в заметку рядом с аудио. Если у инструмента нет собственных номеров версий, задайте понятные обозначения своим рабочим материалам, чтобы различать результаты разных попыток.
При исправлении урока создавайте новый файл, сохраняя предыдущую озвучку и её запись настроек. Тогда можно установить, связан ли изменившийся голос с новым текстом, другой моделью или параметрами. Перед заменой дорожки прослушайте исправленный фрагмент вместе с соседними и убедитесь, что выбрали нужную версию для этой сцены.
Запишите своим голосом короткий контрольный текст и сохраните его отдельно от материалов для создания модели. Включите спокойное объяснение и реплику с заметным смысловым акцентом. Получив модель, озвучьте тот же текст: теперь можно сравнивать одинаковые слова с живым образцом, не полагаясь только на память о своём голосе.
Прослушивайте пары на сопоставимой громкости и отмечайте конкретные различия в ритме, окончаниях и интонации. Если сравниваете две версии модели, используйте один контрольный текст для обеих. Так изменение результата легче связать с версией, а удачное произношение одной знакомой фразы не подменит оценку всей подборки.
Это создание голосовой модели по образцам речи человека. Затем модель используют для произнесения новых текстов с похожими характеристиками звучания. Результат может отличаться от оригинала по интонации, эмоциям и произношению.
Подойдёт разборчивая речь одного человека без музыки, эха и сильной обработки. Требования к длительности, формату и числу образцов зависят от выбранного инструмента. Проверяйте их до записи: один длинный шумный файл не обязательно полезнее нескольких чистых фрагментов.
Используйте чужой голос только с явным разрешением его владельца на создание и применение модели. Не выдавайте синтезированную речь за настоящие слова человека. Для собственных проектов проще начать со своего голоса.
Точное совпадение не гарантируется. Помимо тембра, слушатель воспринимает ритм, произношение, дыхание и эмоции. Оценивайте модель на разных фразах, особенно на словах и интонациях, которых не было в исходном образце.
Готовый голос уже настроен для синтеза речи. Для озвучки своим голосом сначала создают персональную модель по образцам, затем проверяют её на новом тексте. Сходство тембра не гарантирует точной интонации: ударения, вопросы и эмоциональные фразы нужно прослушать отдельно.